Claude Opus 5.5:Anthropic 新旗艦模型,效能接近 Fable 5.1、成本比 Opus 5 少 40%
出處:Anthropic〈Introducing Claude Opus 5.5〉,Anthropic 官網,2026-09-22。閱讀原文
原文作者:Anthropic。本文為 Jean 整理的中文導讀,依原文段落順序改寫,非官方翻譯;文中圖片出自原文,版權屬 Anthropic。
一句話版本
Opus 5.5 是 Claude 5.5 系列的第一個模型。官方說它在多數工作上跟 Claude Fable 5.1 同一個等級,但跑起來比 Opus 5 便宜 40%。這也是 Anthropic 提出「pacing the frontier(控制前沿推進速度)」之後第一個發表的模型,發表前交給 METR、Frontier Design 等外部單位測過。Sonnet 5.5 和 Haiku 5.5 隨後在幾週內推出。
四個主要改變
- 效能:一位測試者用它在一天內完成 68 萬行程式的遷移,原本要一個工程團隊做好幾週。要它縮短網頁 app 每一頁的載入時間,40 次成功 39 次;Opus 5 改得比較少,還動到了 app 原本的行為。
- 安全:在官方的自動行為稽核拿到歷來最高分。比較不會做難以復原的動作、不會超出被授權的範圍,也比 Opus 5 更能抵抗 prompt injection。因為生物和資安能力跟 Claude Mythos 5.1 相當,套用跟 Fable 5.1 類似的防護。
- 成本與速度:預設設定下,一般工作比 Opus 5 少花 40%。輸入、輸出每百萬 token $4 / $20(少 20%),快取讀取 $0.20(少 60%)——agent 和寫程式的成本大部分花在快取讀取。輸出速度快 30% 以上。另外 Pro、Max、Team、席位制 Enterprise 的五小時用量上限提高,訂閱用戶多一次可以存起來、自己決定何時用的用量重置。
- 溝通:寫得更清楚、重點放前面。有測試者說「它寫得跟我一樣」。官方認為好讀也代表好檢查,這同時是安全上的好處。
評測分數
官方先講了一個前提:能力到這個程度,評測分數的差距已經不太能代表實際使用的差異,他們自己用起來,Opus 5.5 和 Fable 5.1 的差距比分數顯示的小。
| 評測 | 測什麼 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 在命令列完成多步驟任務 | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 | 改的程式能不能直接被合併 | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 真實 Cursor 工作裡的模糊、多檔案任務 | 57.8% | 51.8% | 46.6% | — |
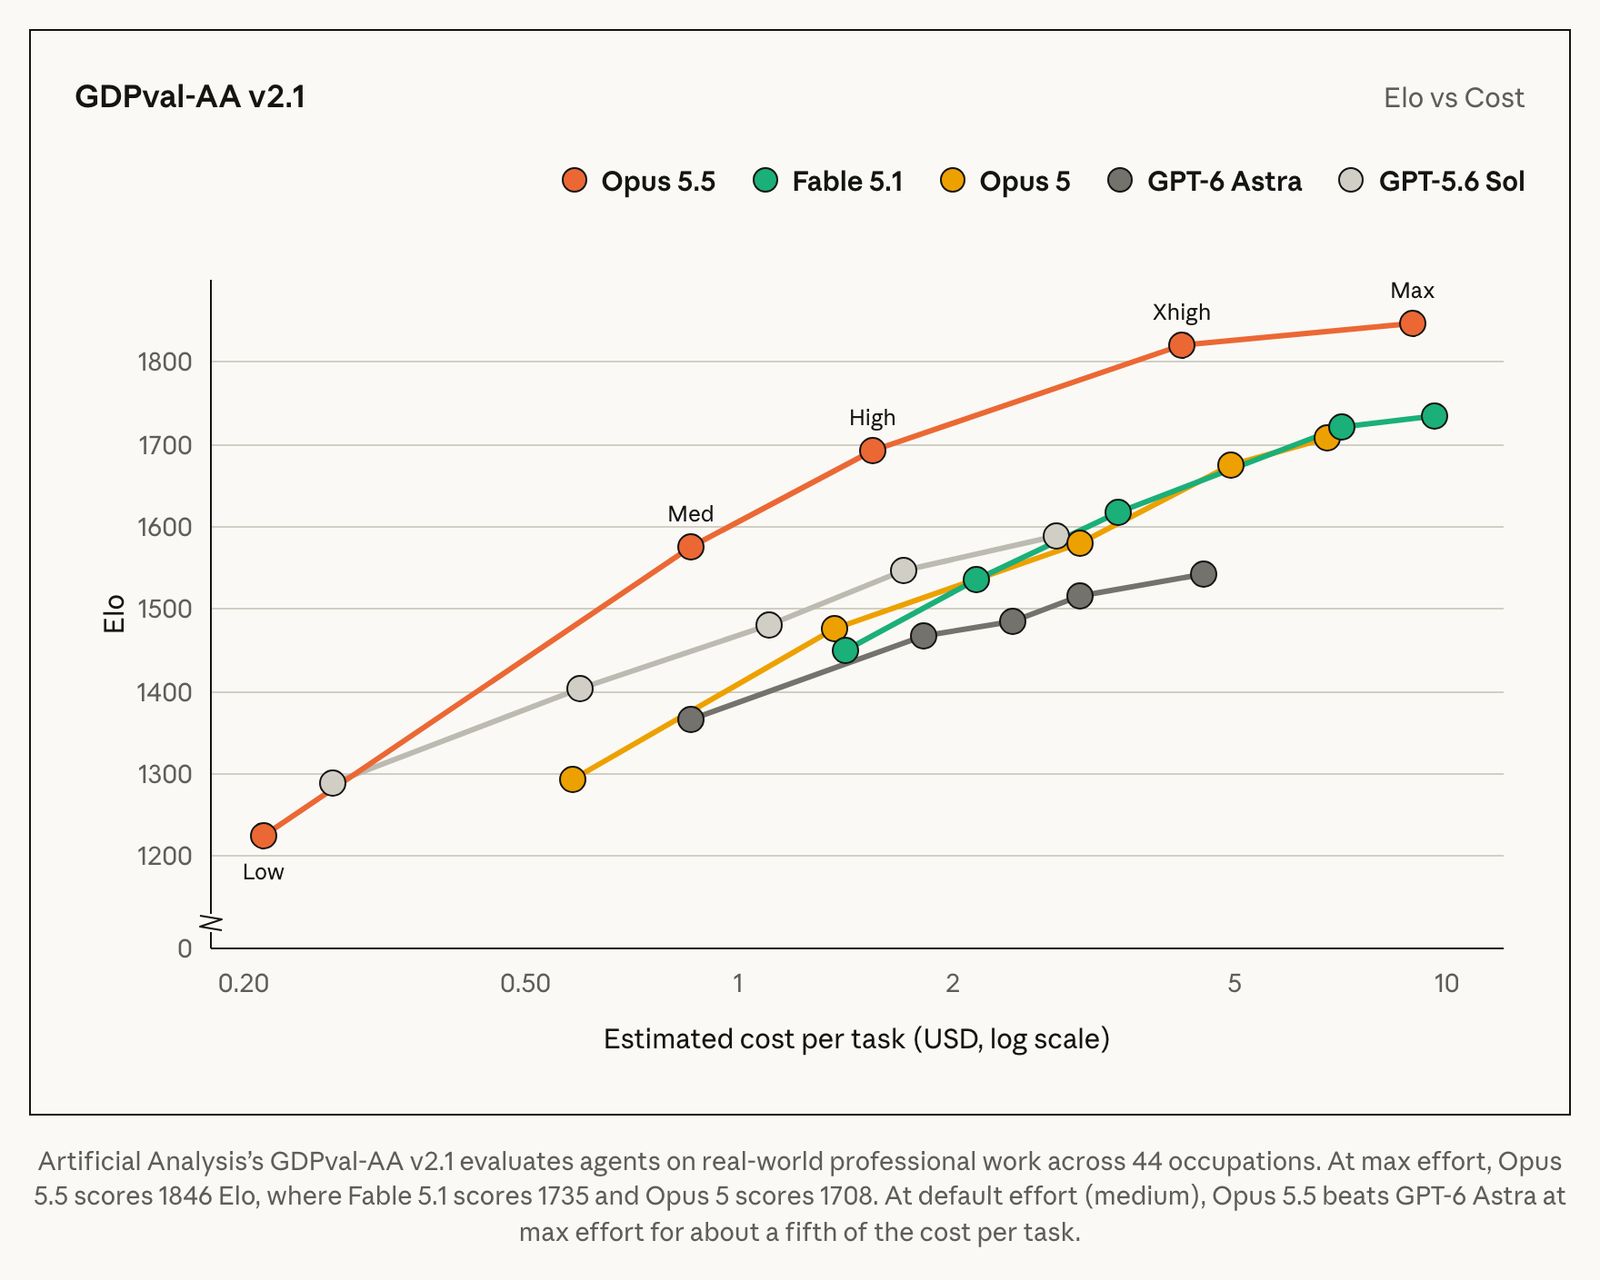
| GDPval-AA v2.1 | 44 種職業的實際工作(Elo 分數) | 1846 | 1735 | 1708 | 1542 |
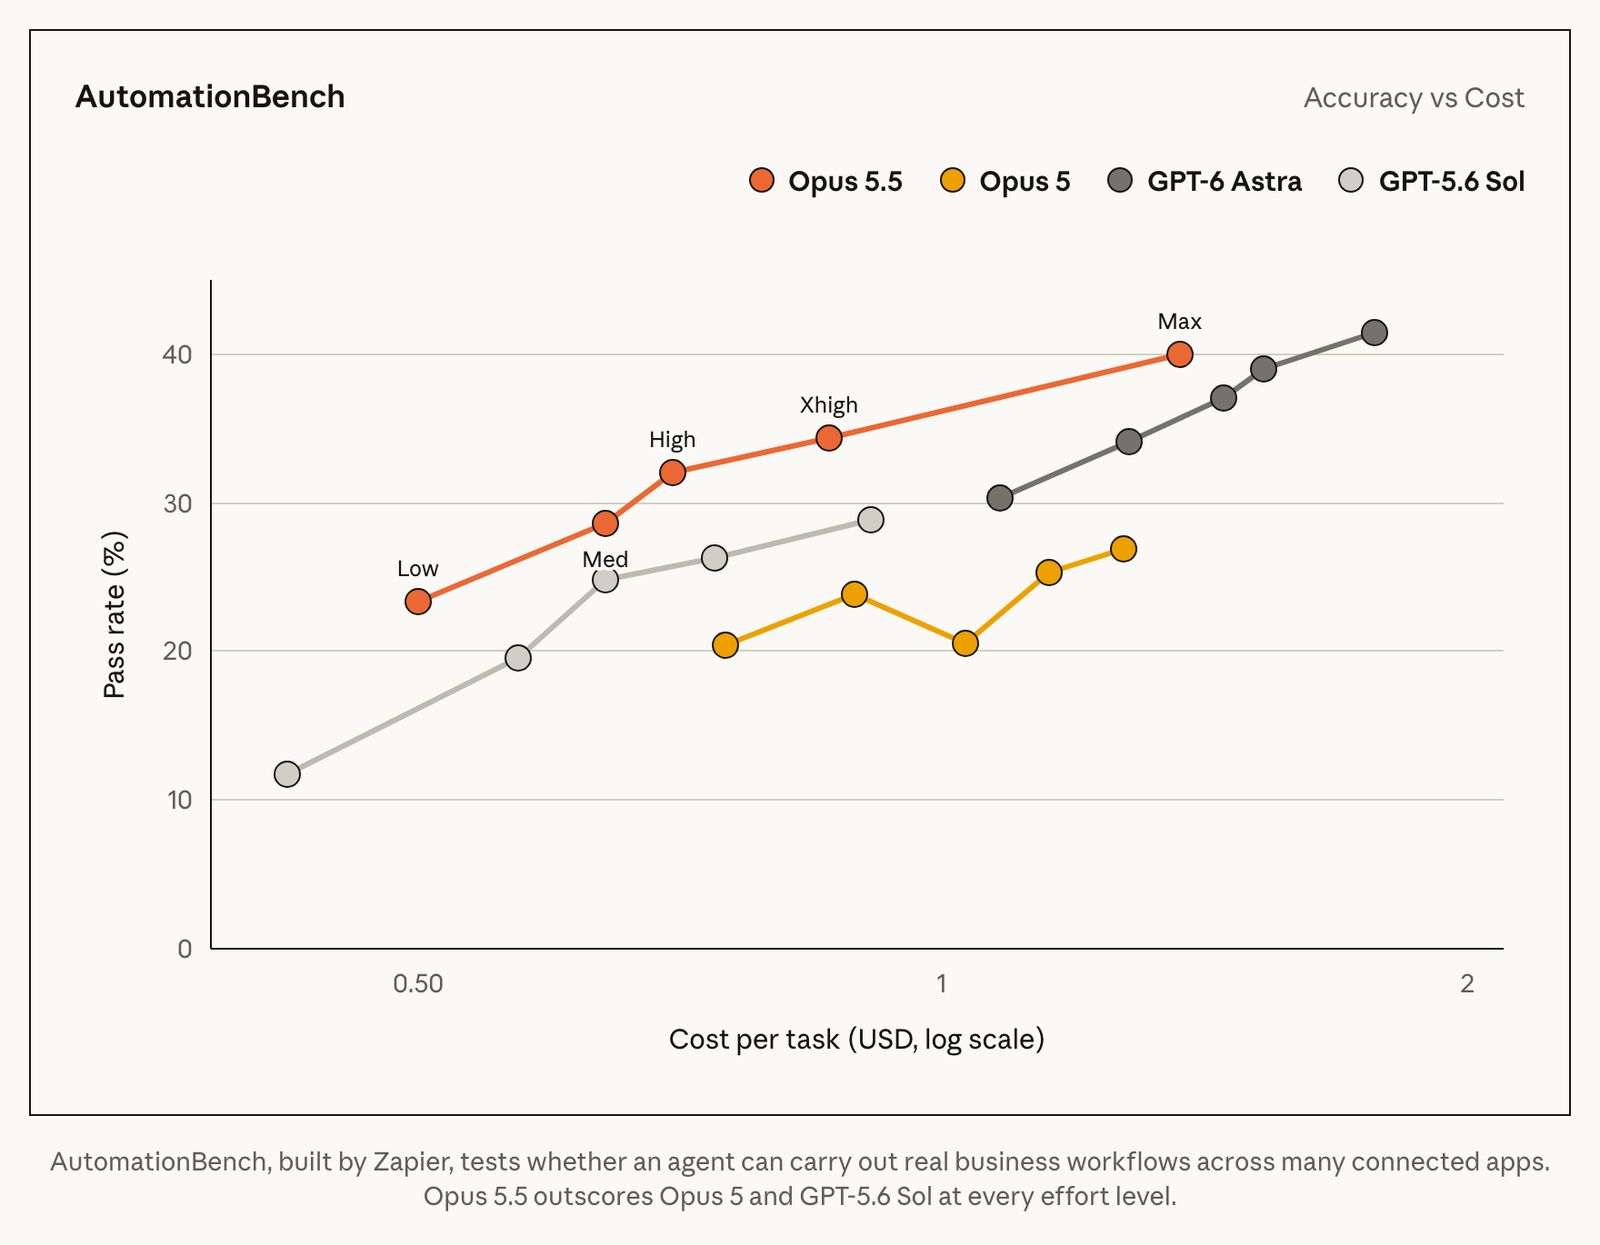
| AutomationBench | 跨多個 app 的商業流程 | 40.0% | 31.4% | 26.9% | 41.4% |
| Humanity's Last Exam(含工具) | 專家級跨領域推理 | 67.7% | 65.6% | 63.6% | 57.2% |
| Terminal-Bench-Science 0.1 | 科學研究任務 | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.1(部分) | 操作一台真的電腦 | 81.8% | 80.7% | 74.0% | — |
| Chartography(含工具) | 看懂圖表 | 89.0% | 88.4% | 83.4% | — |
(原文另有 GPT-5.6 Sol 一欄,這裡省略。)
幾個測試條件:除非另外註明,Opus 5.5 都是開最高 effort(max)加自適應思考;Terminal-Bench 用的是 xhigh。測試時開著正式上線的防護,被攔下的資安題改由 Opus 4.8 做、生物和前沿 LLM 開發題改由 Opus 5 做,官方說這可能拉低了分數。AutomationBench 由 Zapier 執行、沒有備援模型,被防護攔下就直接算失敗。表中 AutomationBench 和 Terminal-Bench-Science 兩項是 GPT-6 Astra 比較高。
官方說最明顯的優勢在效率:每個 token 比較便宜,每個任務用的 token 也比較少,合起來成本少 40%。
價格
| 每百萬 token | Opus 5.5 | Opus 5 |
|---|---|---|
| 快取讀取 | $0.20 | $0.50 |
| 輸入 | $4 | $5 |
| 輸出 | $20 | $25 |
| 快取寫入 | $5 | $6.25 |
Claude Code 和 Claude Platform 另有 Fast mode,速度最高 2.5 倍,每百萬 token 輸入 $8、輸出 $40。
寫程式
Opus 5.5 特別適合又長又大的工作,例如整個程式碼庫的遷移和稽核:
- 一位測試者用它稽核並修好一個 20 萬行的專案,花不到 3 小時;Opus 5 花了超過 20 小時,token 用量是 2.5 倍。
- 內部測試把 HAProxy(一套常用來分配網站流量的軟體)從 C 改寫成 Rust。Opus 5.5 和 Fable 5.1 的版本都幾乎通過 HAProxy 自己的全部回歸測試,但 Opus 5.5 花 9.5 小時、Fable 5.1 花 12 小時,成本少 51%。
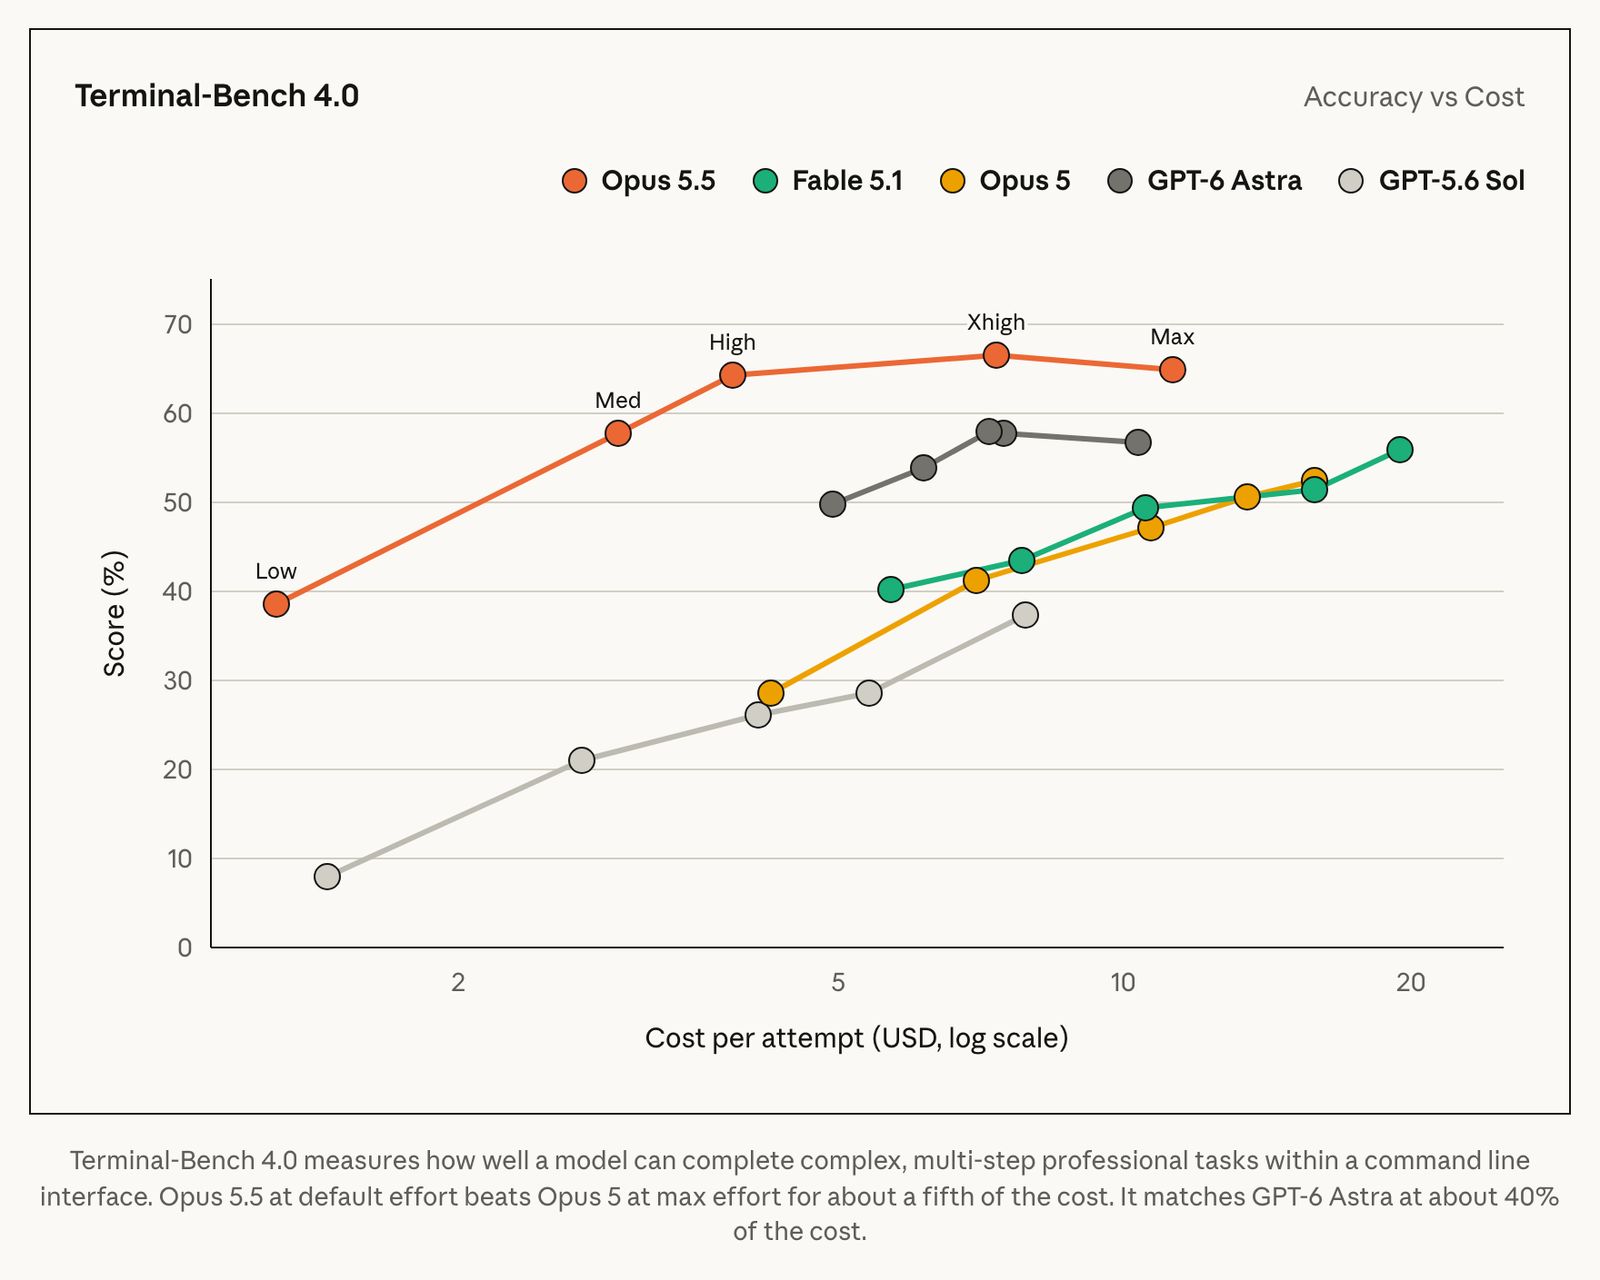
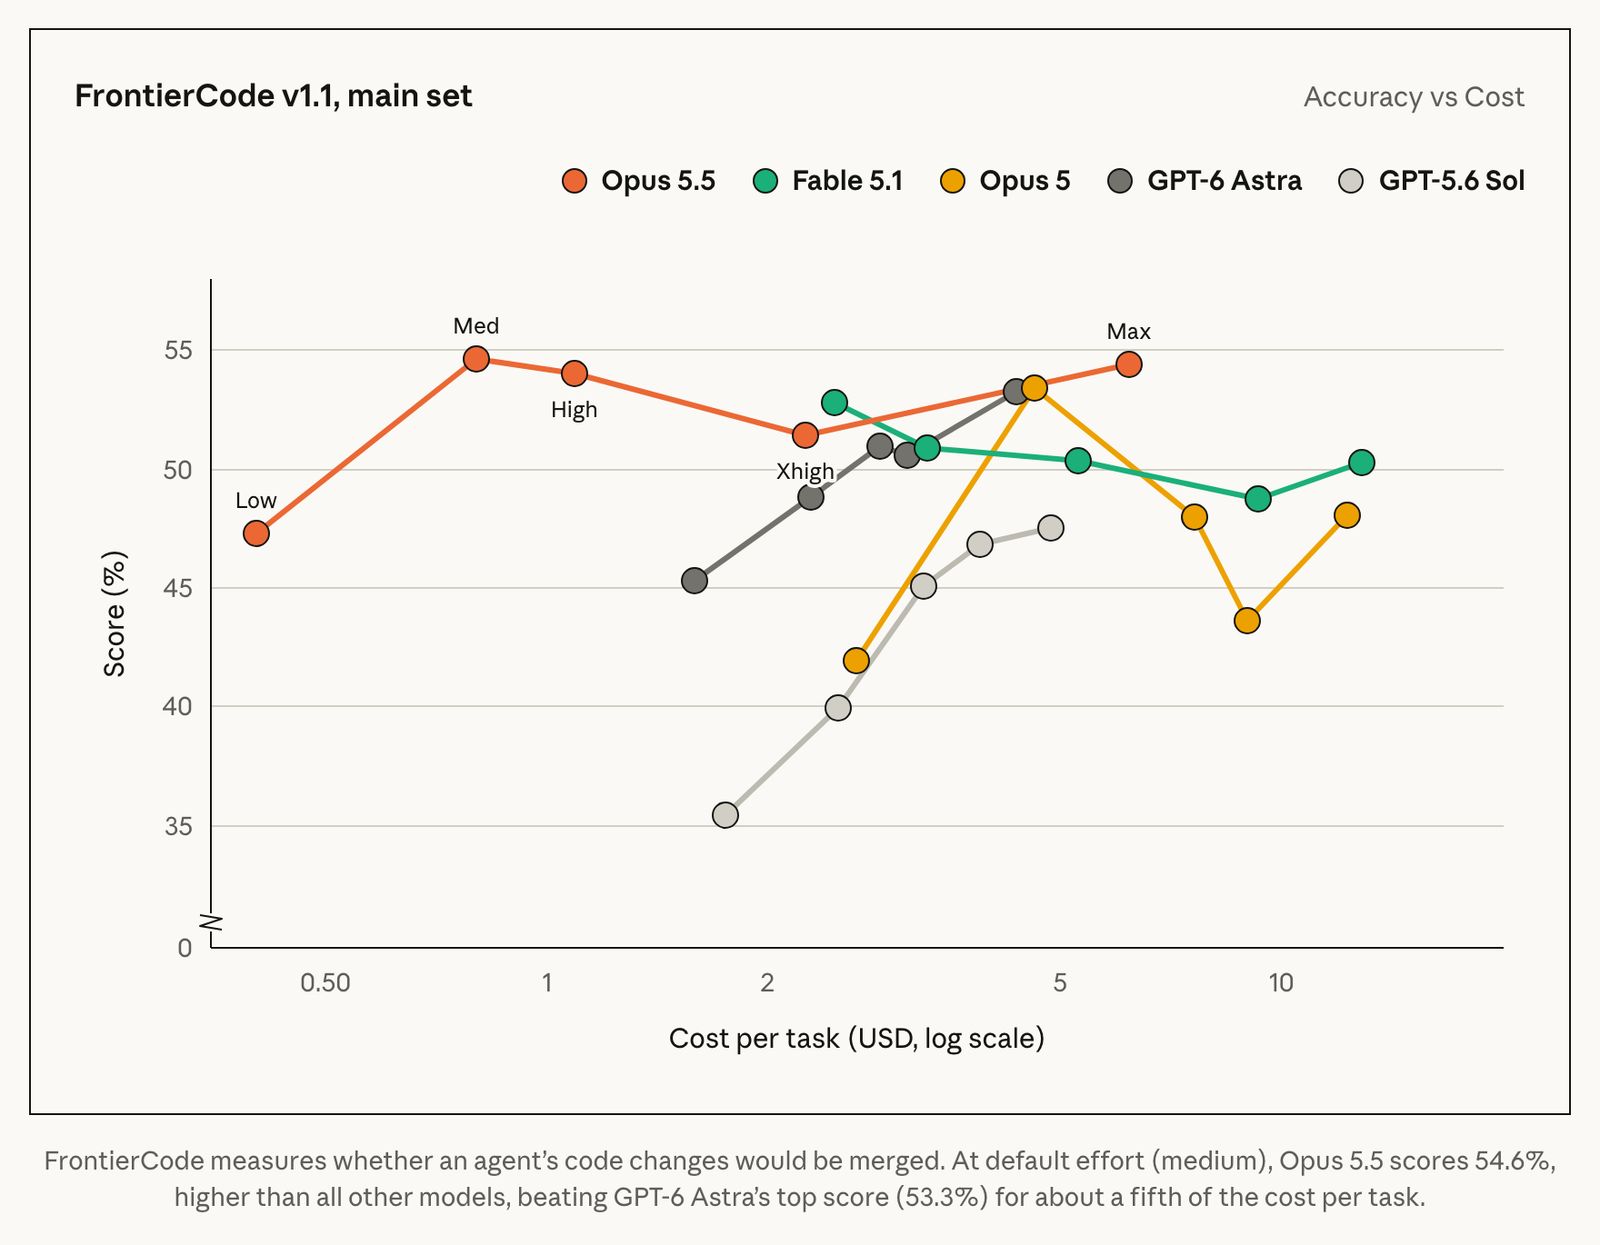
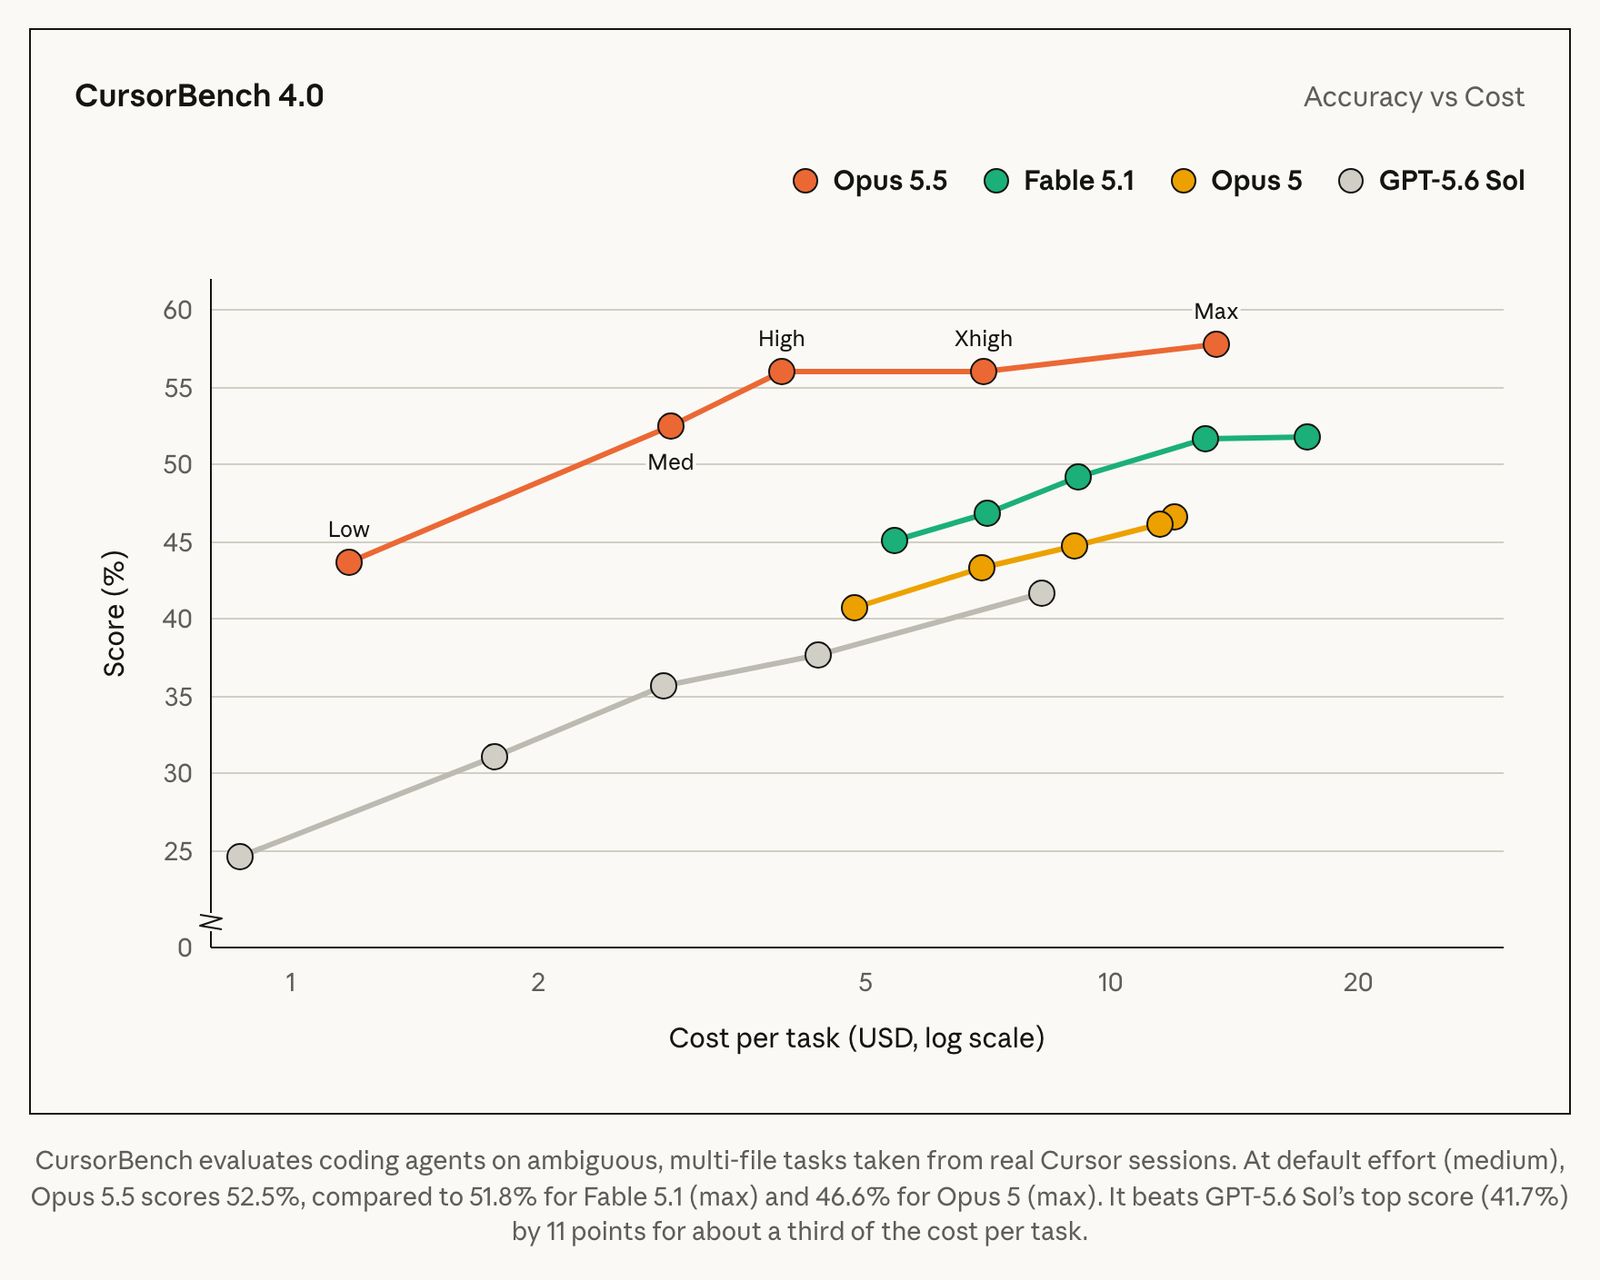
原文附三張「分數對成本」圖,重點是用多少錢拿到多少分:
- FrontierCode:預設 effort(medium)就拿 54.6%,比 GPT-6 Astra 的最高分 53.3% 還高,每個任務的成本約五分之一
- Terminal-Bench:預設 effort 就贏過開 max 的 Opus 5,成本約五分之一;追平 GPT-6 Astra,成本約 40%
- CursorBench:預設 effort 拿 52.5%,比 GPT-5.6 Sol 的最高分 41.7% 多約 11 分,成本約三分之一
早期測試者的回饋(摘要):
- GitHub:在 Copilot CLI 和 VS Code 裡是用 token 和步數最少的模型之一;VS Code 的終端任務解得比 Opus 5 多,步數不到一半
- Clio:跨六個 repo 的工程任務讓它整夜自己跑,連續做了 18 小時以上,程式註解簡短實用
- Quantium:原本要 38 個 prompt、花四天的複雜任務,變成 11 個 prompt、三小時
- Optiver:寫程式任務用一半的回合、時間和輸出 token 達到 Opus 5 的品質,成本少 40–50%
- Column:分派子代理的能力好很多,也會用有創意的方式檢查自己的成果
最安全的寫程式 agent
企業讓 agent 自己跑好幾個小時,需要確定它照預期在做事。Opus 5.5 配了三道關卡:每個動作執行前有分類器先篩、資安團隊可以稽核的開源沙盒、合併前抓漏洞的 code review。
模型本身也更能抵抗 prompt injection(藏在網頁或檔案裡、想騙模型做事的指令):在寫程式、使用工具、操作電腦、瀏覽網頁每種情境都追平或勝過 Opus 5;在資安公司 Gray Swan 的測試中,跟 Fable 5.1 並列攻擊成功率最低。
知識工作
- 研究:在一份「財報很難找到」的網路複本上寫公司季度報告,自動評分會逐一核對每個數字和引言,只要有一處是捏造的就不及格。Opus 5.5 寫的 18 份裡 16 份通過;Fable 5.1 和 Opus 5 一次都沒通過。
- 財務分析:投資公司 Walleye Capital 說,Opus 5.5 開最低 effort 就大致解完他們的評測;開高一點,還發現他們題目說明裡的分鐘索引差了一,主動修正並說明這樣會被扣分。之前沒有模型抓到過。
- 併購分析:要 Opus 5.5 和 Opus 5 分析兩家虛構 HR 軟體公司的合併案,做 Excel 財務模型再轉成高層簡報。兩者結論相同,Opus 5.5 的模型比較完整、簡報比較好讀,Opus 5 有小錯;Opus 5.5 花 63 分鐘、Opus 5 花 93 分鐘,成本少 50%。
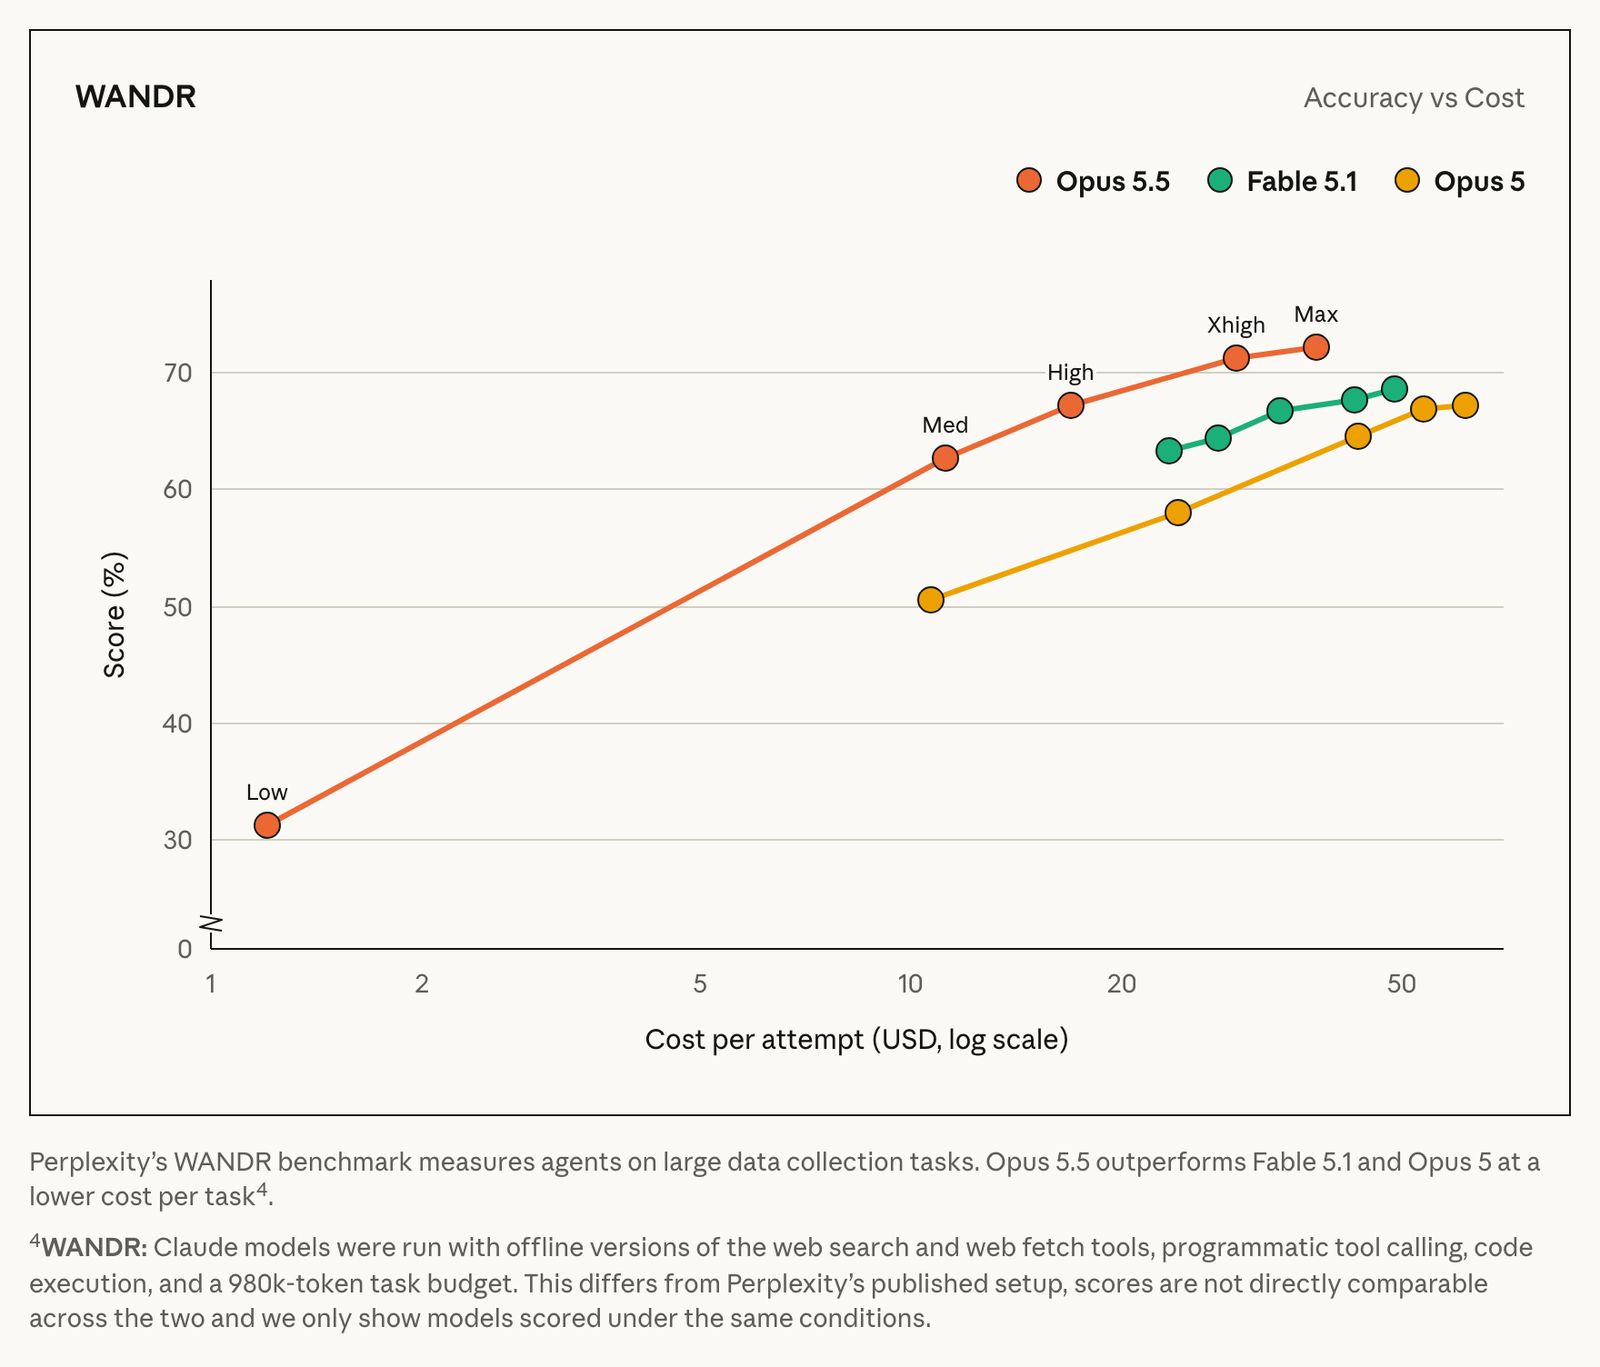
- 評測:GDPval-AA 拿 1846 Elo;預設 effort 就贏過開 max 的 GPT-6 Astra,成本約五分之一。AutomationBench 在每個 effort 等級都贏 Opus 5 和 GPT-5.6 Sol;Perplexity 的大量資料蒐集評測 WANDR 也贏 Fable 5.1 和 Opus 5,成本更低(測試設定跟 Perplexity 官方不同,分數不能直接拿去比)。
客戶回饋(摘要):
- Deloitte:最低 effort 就抓到 72% 的已知 bug,Opus 5 開高 effort 是 56%
- Rogo:最低 effort 在 BigFinance Bench 贏過開高 effort 的 Opus 5,輸出 token 少約 60%
- Hex:一題問「包裹是真的延遲,還是只是追蹤資訊慢」。Opus 5 查了送達確認就說追蹤正常;Opus 5.5 發現包裹真的延遲,追蹤系統也壞了
- Hebbia:金融工作流程的專家評分項目,Opus 5.5 涵蓋 86.6%,Opus 5 是 60.3%
溝通
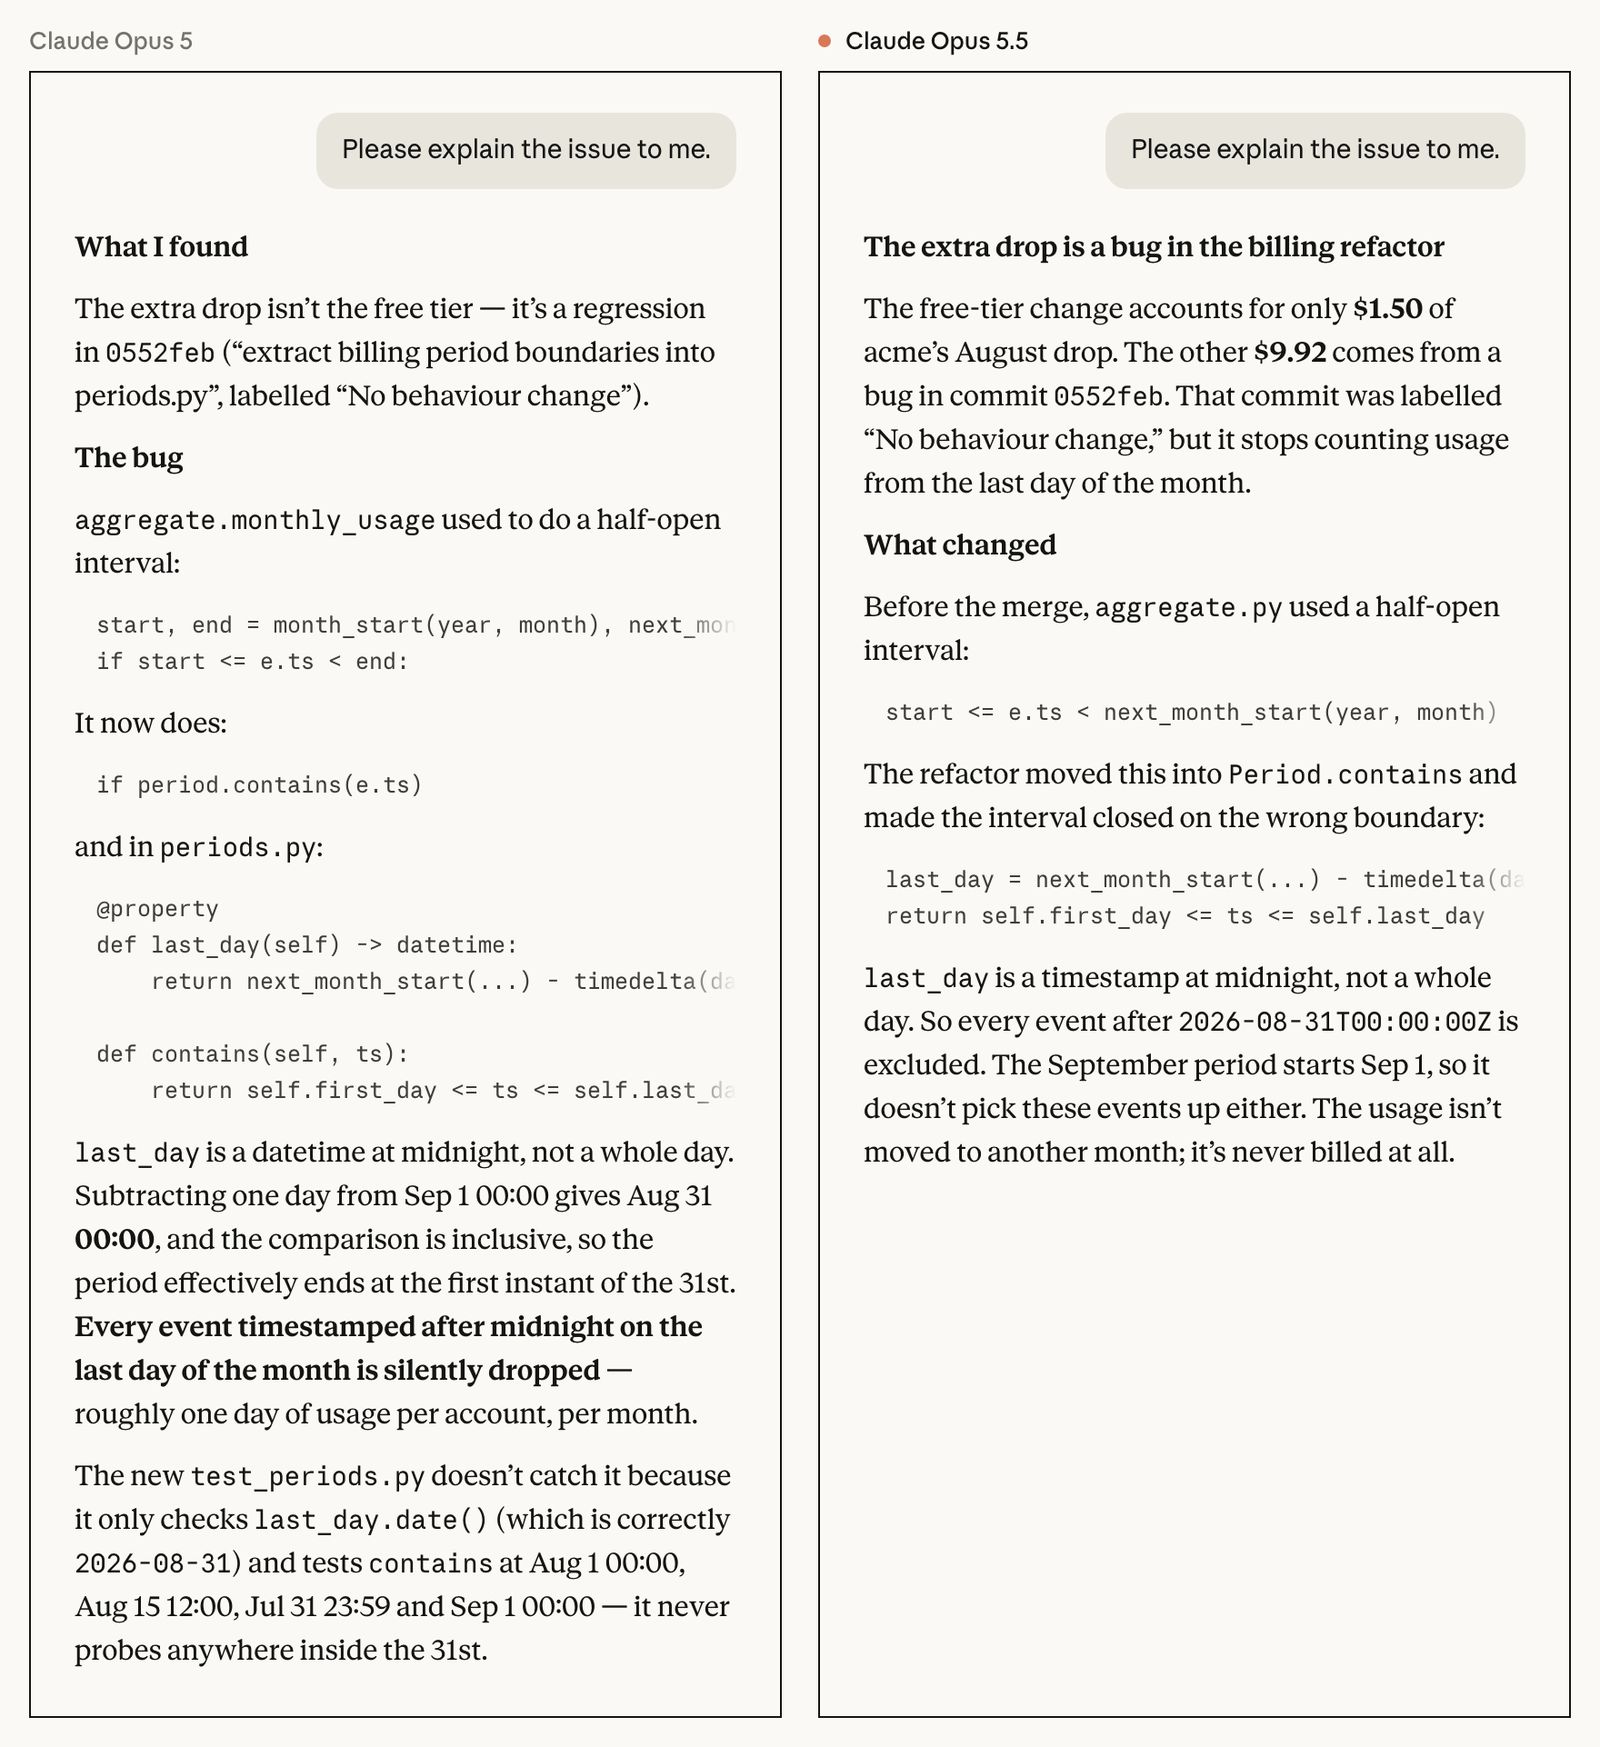
Opus 5 最常被反映的問題之一是寫得難讀。Opus 5.5 的訊息一眼就能看懂,重點放前面,比較少用術語和怪詞,也會照你給的寫作規則。
原文放了三組並排對照:解釋 bug、幫主管摘要 Slack 討論串、解釋設計修改。以計費 bug 那組為例:Opus 5 一開頭就是技術細節(哪個區間、哪段程式);Opus 5.5 第一句先講結論和金額——客戶八月的帳單少掉的部分,免費方案調整只佔 $1.50,另外 $9.92 是某個 commit 的 bug 造成的,每個月最後一天的用量都沒被計費——然後才解釋原因。
客戶回饋(摘要):
- Ramp:冗長難讀一直是他們對前沿模型最大的不滿,這次被修好了;它寫的設計規格幾乎不用改
- Stripe:40 個疊在一起的 PR 要花好幾天 rebase,一個 Opus 5.5 session 指揮另外十幾個 session,隔天下午 40 個全部通過 CI
- Box:token 用量是 Opus 5 的三分之一,回答精簡 40%,準確度沒掉
- Factory:第一個他們會預設開 medium 的模型,表現追平開 high 的 Opus 5,輸出 token 少 20–25%
安全
控制前沿推進速度
發表前一週,Anthropic 執行長 Dario Amodei 主張 AI 的進展要控制速度,讓安全做法跑在能力前面。安全工作同時看兩條時間線:
- 現在的模型:大量對齊測試、外部機構(METR、Frontier Design)發表前評估、依能力在資安和生物等高風險領域配防護,並在負責任擴展政策(RSP)的風險報告公開結果。
- 未來的模型:更嚴格篩選強化學習用的環境(有缺陷的環境是行為偏差的主要來源)、改進對齊獎勵、自動產生多樣的安全訓練情境,並加強資安與監控,特別是用可解釋性技術做監控,減少只靠讀模型寫出來的思考過程。
至於能完全自動做 AI 研究的模型,官方說需要更高的安全標準,不認為現有做法單獨就夠,也認為公共政策要扮演更大的角色。
對齊
在近 2,000 個情境的自動行為稽核裡,Opus 5.5 幾乎每一項行為偏差指標都是近期 Claude 模型中最好的,多數誠實度指標也最強。跟近期資安事件有關的幾種行為都有改善:偏頗的推理、試圖逃出沙盒、認定自己在模擬環境就做出有害動作。新的「越界」測試中,它嘗試突破限制的次數比 Opus 5 或 Mythos 5.1 少約 85%,每次都屬低嚴重度,而且都自己回報了。
限制也寫得很清楚:部署前抓到所有失敗仍是沒解決的問題;Opus 5.5 常常懷疑自己正在被測試,讓評估它在真實環境的表現更困難。
防護
Opus 5.5 是第一個在資安、生物、蒸餾三方面套用跟 Fable 5.1 同類防護的 Opus,被攔下時會公開改由別的模型接手:
- 資安:日常開發中找 bug、修 bug 可以照常做,但多數資安任務會轉給 Opus 4.8。Cyber Verification Program 即將擴大到 Opus 5.5,分三個等級開放。
- 生物:能力超過 Opus 5,很多方面追平或超過 Mythos 5.1,所以用跟 Fable 5.1 一樣的防護。學術實驗室、新創、藥廠可以申請 Life Sciences Verification Program。
- 蒸餾:有人會用上千個假帳號大規模抽取模型能力。Preserved thinking 讓 API 使用者沒辦法改寫先前的上下文來套出 Claude 的推理,適用 2026-08-31 之後建立的 API 帳號。
- 資料與法規:可以零資料保留;附有符合歐盟 AI 法的浮水印;不能再關掉 thinking 模式。
哪裡可以用
所有平台都能用,包括 AWS、Google Cloud、Microsoft Azure。在 Claude Platform 的模型 ID 是 claude-opus-5-5,官方另有遷移指南。
詞彙對照
| 原文 | 意思 |
|---|---|
| agentic coding | 讓 AI 自己規劃、執行多個步驟來完成程式任務,而不是只回答一段程式碼 |
| effort | 投入程度:控制模型想多深、花多少 token,分 low / medium / high / xhigh / max |
| benchmark | 評測:用固定題目比較模型表現的測試 |
| cache read | 快取讀取:之前送過、內容沒變的部分,重讀時用便宜很多的價格計費 |
| subagent | 子代理:主要的 agent 把一部分工作分出去給另一個模型處理 |
| prompt injection | 提示注入:藏在網頁或檔案裡、試圖讓模型違背使用者意思的指令 |
| alignment | 對齊:模型的行為符合人的意圖和價值 |
| safeguard / fallback | 防護/備援:偵測到高風險請求時,改由較保守的模型處理 |
| distillation | 蒸餾:用大模型的輸出去訓練另一個模型,這裡指未經授權的抽取 |
| zero data retention | 零資料保留:請求處理完不留存資料 |