Claude Sonnet 5.5:比 Sonnet 5 快 30%、成本少三成的日常主力模型
出處:Anthropic〈Introducing Claude Sonnet 5.5〉,Anthropic 官網,2026-09-28。閱讀原文
原文作者:Anthropic。本文為 Jean 整理的中文導讀,依原文段落順序改寫,非官方翻譯;文中圖片出自原文,版權屬 Anthropic。
一句話版本
Sonnet 5.5 是 Claude 5.5 系列的第二個模型(第一個是 Opus 5.5)。定位是 Opus 5.5 的「更快、更便宜」搭檔:Opus 5.5 負責需要仔細判斷的複雜工作,Sonnet 5.5 擅長範圍明確的日常任務、修 bug,以及做文件、簡報、試算表。官方說它比 Sonnet 5 快 30% 以上,多數工作成本最多少 30%,也特別提到它「對設計有眼光」。
比 Sonnet 5 進步在哪
- 效能:Terminal-Bench 4.0 拿 70.6%,Sonnet 5 是 10.3%。GDPval-AA 只比 Opus 5.5 低兩分。也是第一個只看螢幕截圖就打通《寶可夢 紅》的 Sonnet。
- 合作:跟 Opus 5.5 一樣寫得更清楚,測試者覺得比 Sonnet 5 更好合作。速度快,適合不太複雜的任務快速來回修改。
- 成本:輸入、輸出價格跟 Sonnet 5 一樣(每百萬 token $2 / $10),但同樣的工作通常用少很多 token。快取讀取 $0.10,是 Sonnet 5 的一半。
- 速度:輸出快 30% 以上,是目前最快的 Sonnet。
- 安全:行為稽核的多數對齊指標進步或持平。因為資安能力跟 Opus 5 相當,是第一個帶著資安防護和備援模型上線的 Sonnet。
評測分數
官方特別說明:Sonnet 5.5 開 Max effort 時,有幾項評測跟 Opus 5.5 差不多;但分數只反映一部分能力,在需要長時間判斷的複雜、開放式工作上,Opus 5.5 仍然明顯比較強。
| 評測 | 測什麼 | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 在命令列完成多步驟任務 | 70.6% | 10.3% | 66.4%¹ | — |
| FrontierCode 1.1 | 改的程式能不能直接被合併 | 46.2%(Max)/52.1%(Xhigh)² | 42.4% | 54.4% | 49.3% |
| CursorBench 4.0 | 真實 Cursor 工作裡的模糊、多檔案任務 | 55.5% | 34.1% | 57.8% | — |
| GDPval-AA v2.1 | 44 種職業的實際工作(Elo 分數) | 1844 | 1449 | 1846 | 1487 |
| AA-Briefcase v1.1 | 長時間的知識工作(Elo 分數) | 1811 | 1359 | 1822 | 1483 |
| Humanity's Last Exam(含工具) | 專家級跨領域推理 | 64.5% | 54.9% | 67.7% | — |
| OSWorld 2.1(部分) | 操作一台真的電腦 | 80.1% | 57.0% | 81.8% | — |
| Chartography(不含工具) | 看懂圖表 | 61.6% | 15.6% | 64.4% | 53.6% |
- ¹ Opus 5.5 這項是開 Xhigh 的分數,也是它的最高分。
- ² Sonnet 5.5 開 Max 反而比 Xhigh 低。原因是開 Max 時它更常啟動 Claude Code 的 code-review skill,把審查拆給很多子代理,有兩個案例因此逾時,或改到任務範圍以外的地方——FrontierCode 會扣這種分,就算改得很好也一樣。
- GDPval-AA 和 AA-Briefcase 測試時,Claude Platform 有一個影響結構化輸出的 bug(已修好),官方估計影響很小。GPT-6 Sol 剛修好一個影響圖像理解的 bug,部分第三方分數可能還沒更新。
分數對成本
原文附四張圖,橫軸是每個任務的成本、縱軸是分數,每個 effort 等級畫一個點,越靠左上越划算:
- Terminal-Bench:開 Medium(Claude App 預設)就遠超 Sonnet 5 的最好成績,成本不到十分之一
- FrontierCode:開 High(Claude Platform 預設)追平 GPT-6 Sol 的最好成績,成本約五分之一
- CursorBench:開 Low 就超過 Sonnet 5 的最好成績,成本不到十分之一
- AA-Briefcase:開 Medium 就贏過 Sonnet 5 的最好成績,成本約九分之一
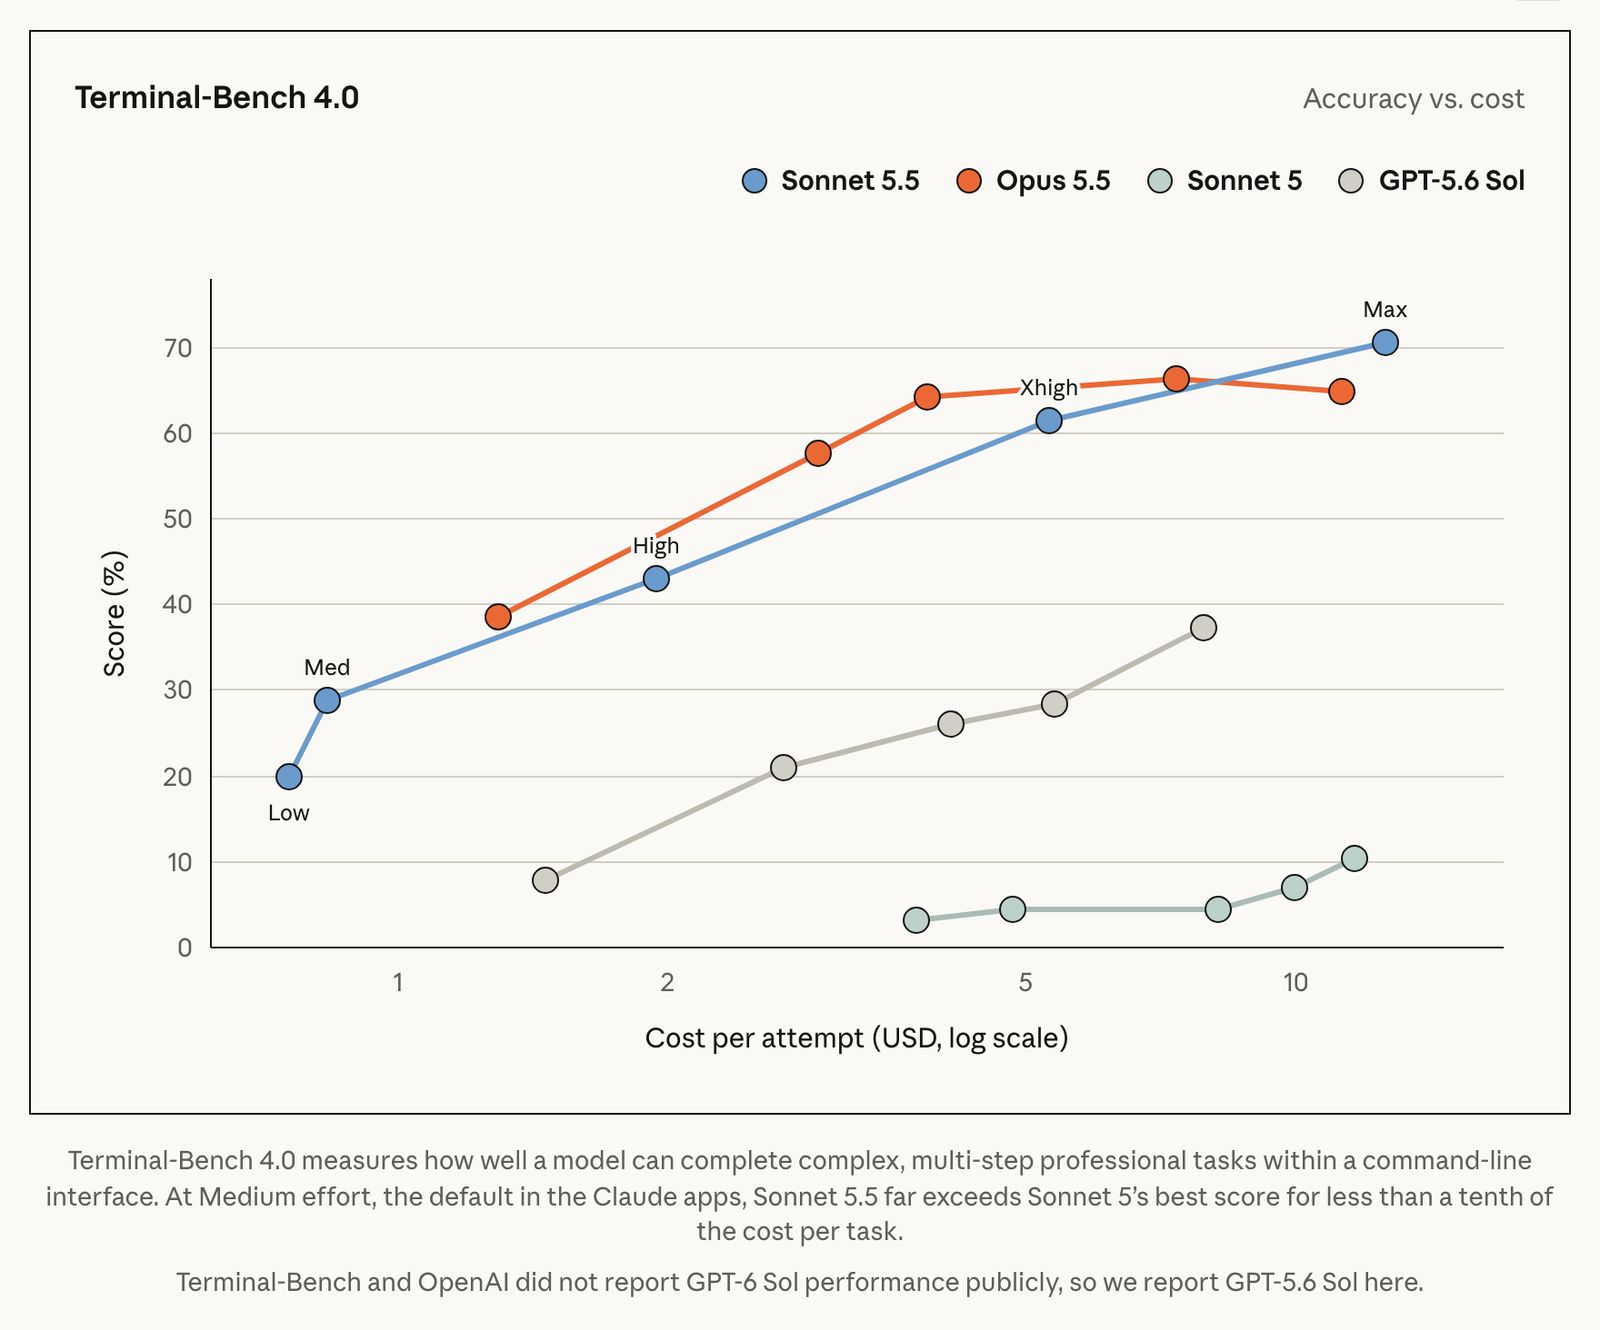
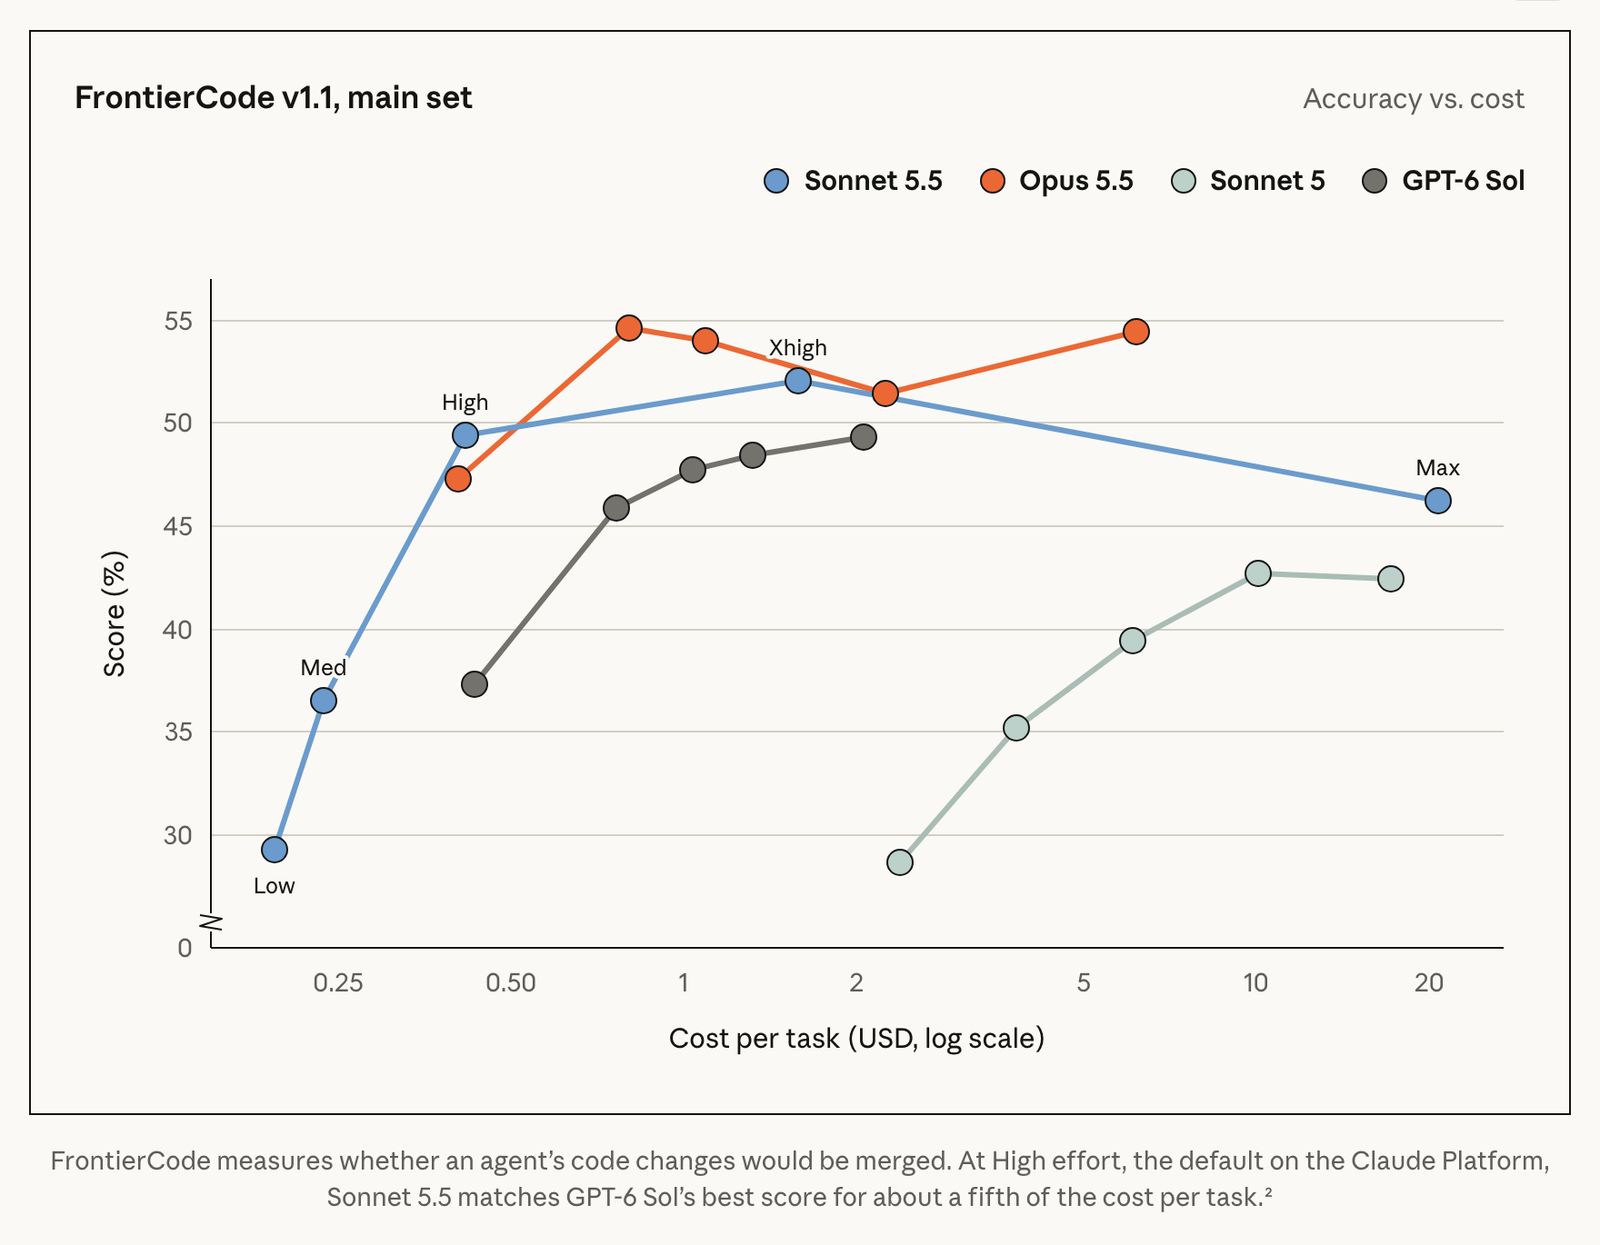
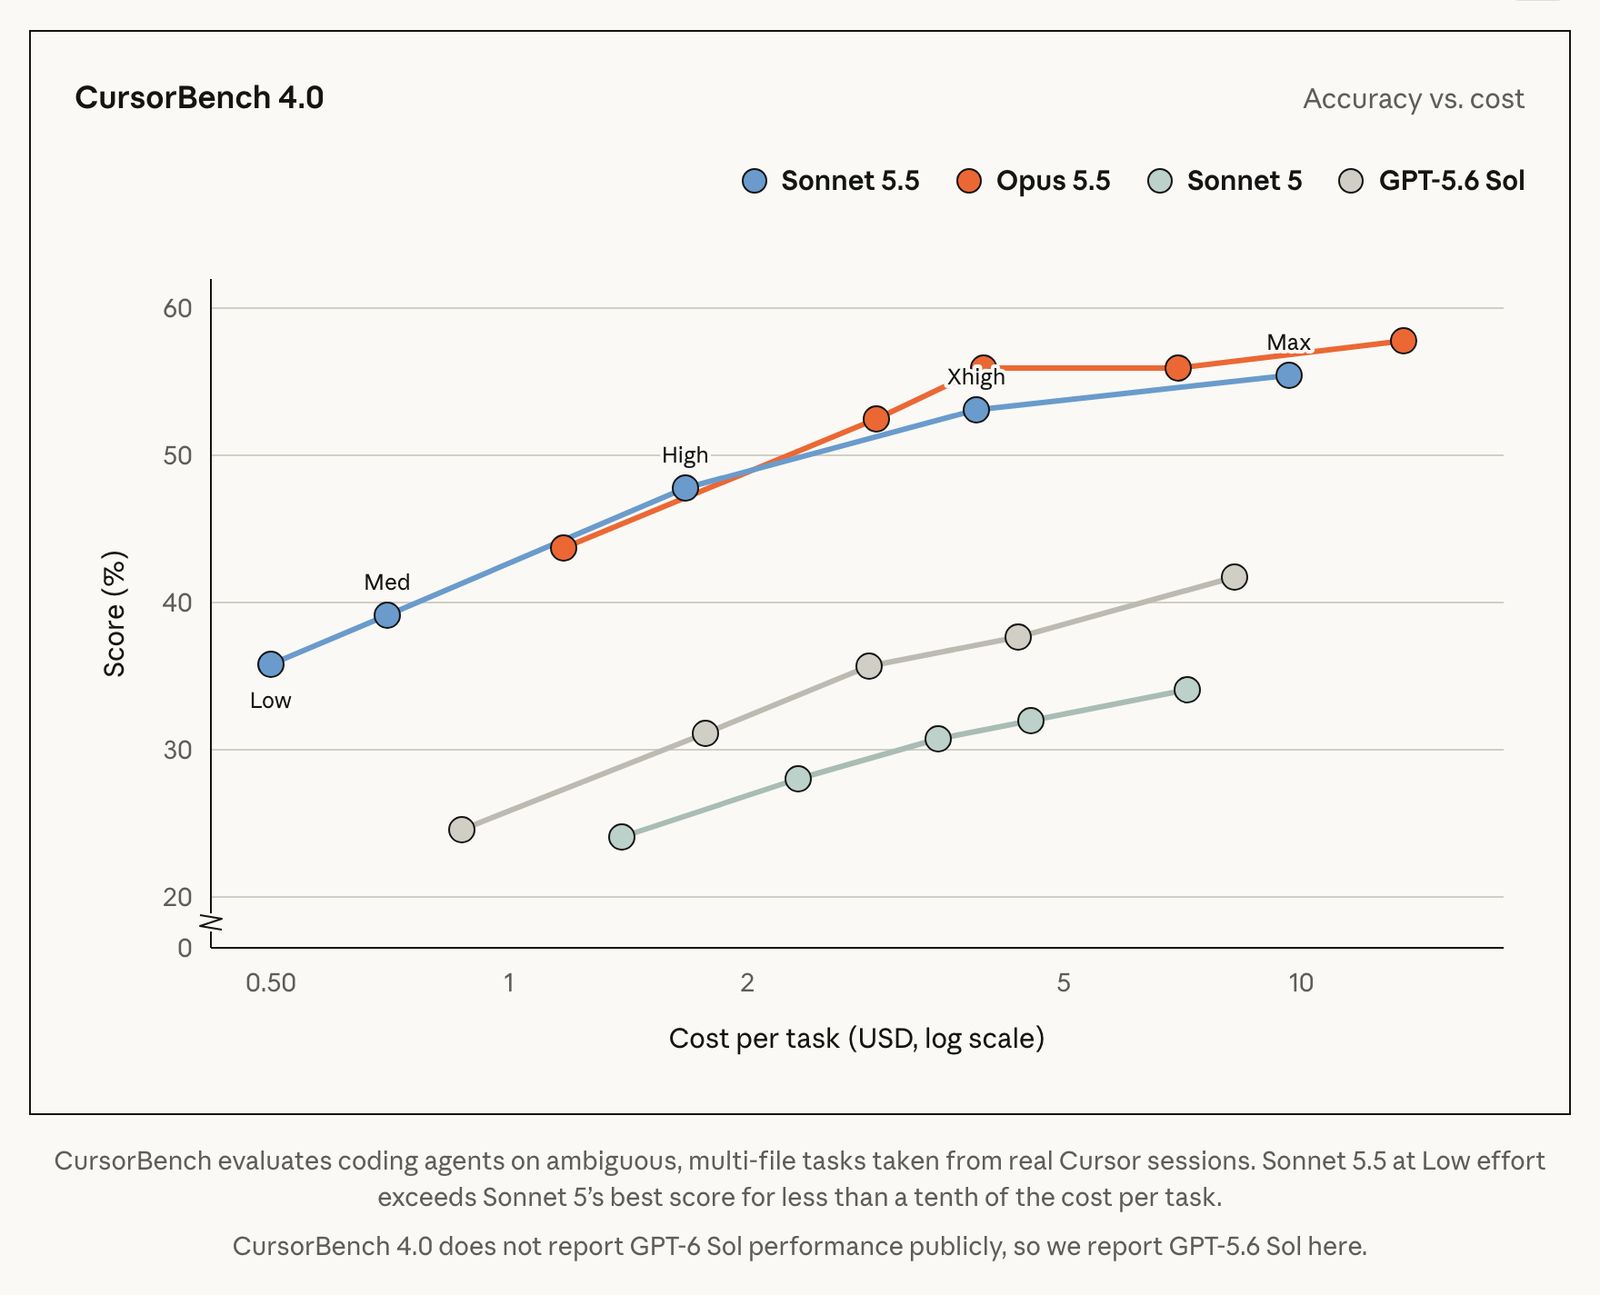
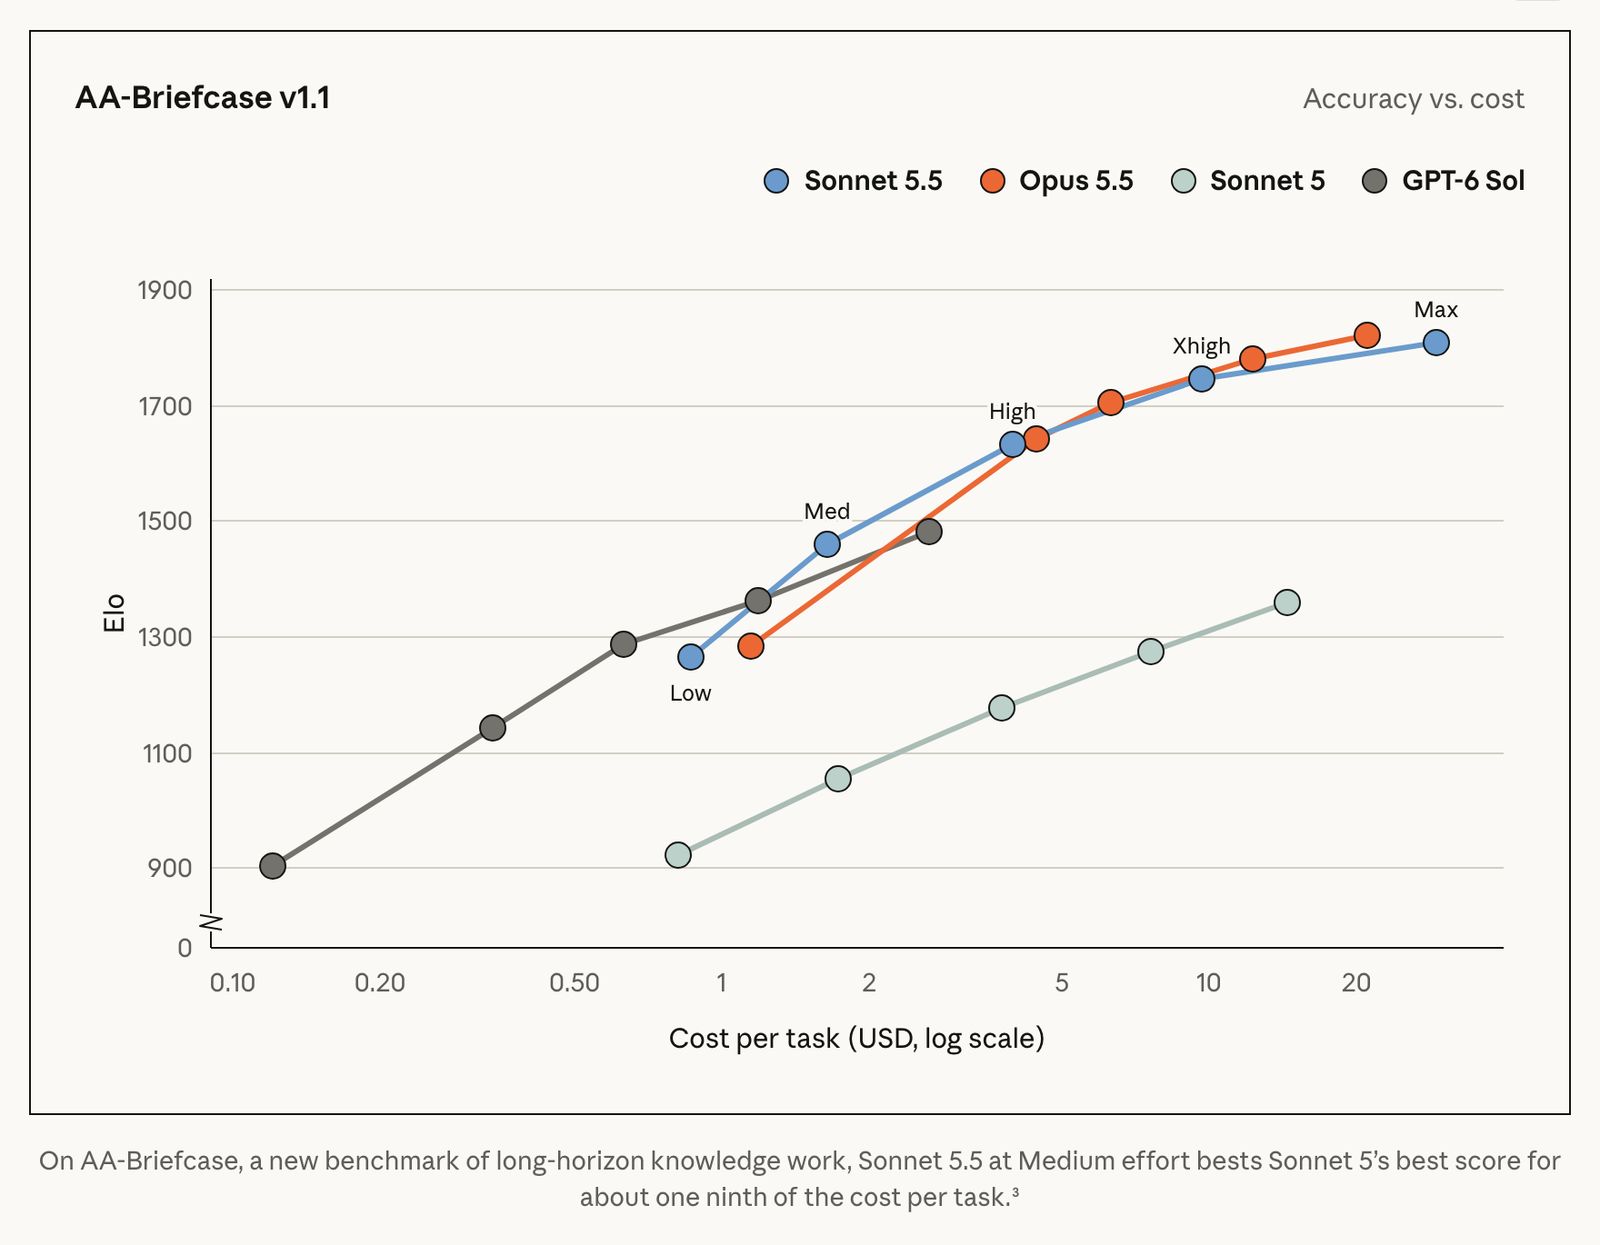
官方的結論是:Sonnet 5.5 開低 effort 時最能跟 Opus 5.5 互補;開到高 effort,表現和成本都會跟 Opus 5.5 差不多。
寫程式
進步最明顯的地方。FrontierCode 同樣開 High,比 Sonnet 5 高 10 分,成本約十五分之一;CursorBench 的最好成績跟 Opus 5.5 只差約兩分。測試者提到它看懂程式碼庫很快,而且會把工具呼叫合併成一批,所以步數少、成本低。
早期測試者的回饋(摘要):
- Epic Games:系統設計稽核、資料流程審查達到更高階模型的水準;能處理數萬行遊戲架構程式和好幾小時的任務,prompt 不用寫那麼細
- CodeRabbit:Sonnet 5 太愛上網搜尋、token 用很兇的問題都不見了;簡單和中等難度的 code review 會先換過來
- Base44:118 個真實 app 建置,品質跟 Opus 5 打平,平均 3.6 次迭代完成(Opus 5 要 7.7 次),失敗的工具呼叫最少,也很少中途停下來問使用者
- Unity:他們會重新打開專案、在執行時檢查,改動真的能動才算完成。多數工作都通過,多步驟的 Unity Editor 加程式評測完成 90%
- Creator:Opus 5.5 定好遊戲的架構之後,可以放心交給 Sonnet 5.5 實作
知識工作
GDPval-AA(44 種職業、9 大產業)幾乎跟 Opus 5.5 打平,比 Sonnet 5 高約 400 分;操作電腦和看圖表接近 Opus 5.5;長時間的知識工作明顯勝過 Sonnet 5 和 GPT-6 Sol。
比較難量化的部分:測試者覺得它對話比較自然,也有設計感——會幫介面補上細節,能照簡報範本做出幾乎不用再改的簡報。內部測試給它一家上市公司的季報資料、法說會逐字稿和簡報範本,要一份 10 頁的營運回顧,兩位專家判斷第一版就能直接寄出。
客戶回饋(摘要):
- Slack:完全不改 prompt,多數離線評測都贏 Sonnet 5,步數更少,輸出 token 少約 14%
- Zendesk:處理客服工單快 20%,做錯決定的次數更少
- Balyasny Asset Management:2,441 個金融任務,每個答案約用 12.1 萬 token(Sonnet 5 是 49.7 萬),七個模型裡品質對成本的比例最好
- Box:會回到原始文件重新核對資料,抓到 Sonnet 5 漏掉的錯;更準、快 2.4 倍、token 少 12%
- Lovable:工具呼叫少三分之一,shell 執行次數約少一半
- Atlassian:Rovo Agents 最多可以快 30%
成本與速度
| 每百萬 token | Sonnet 5.5 | Opus 5.5 |
|---|---|---|
| 快取讀取 | $0.10 | $0.20 |
| 快取寫入 | $2.50 | $5 |
| 輸入 | $2 | $4 |
| 輸出 | $10 | $20 |
(Sonnet 5.5 發表頁現在寫快取讀取 $0.10;但 10 月 7 日的 Haiku 5.5 發表文說,Sonnet 5.5 的快取讀取是當天才從 $0.20 降到 $0.10。兩篇說法對不起來,發表頁的價格可能是事後更新的。)
原文用三個「用一個 HTML 檔做出…」的 prompt 對照 Sonnet 5 和 Sonnet 5.5:400 隻椋鳥群飛、風吹動沙丘、用 24 個小時鐘組成的大時鐘。以下是椋鳥那組:
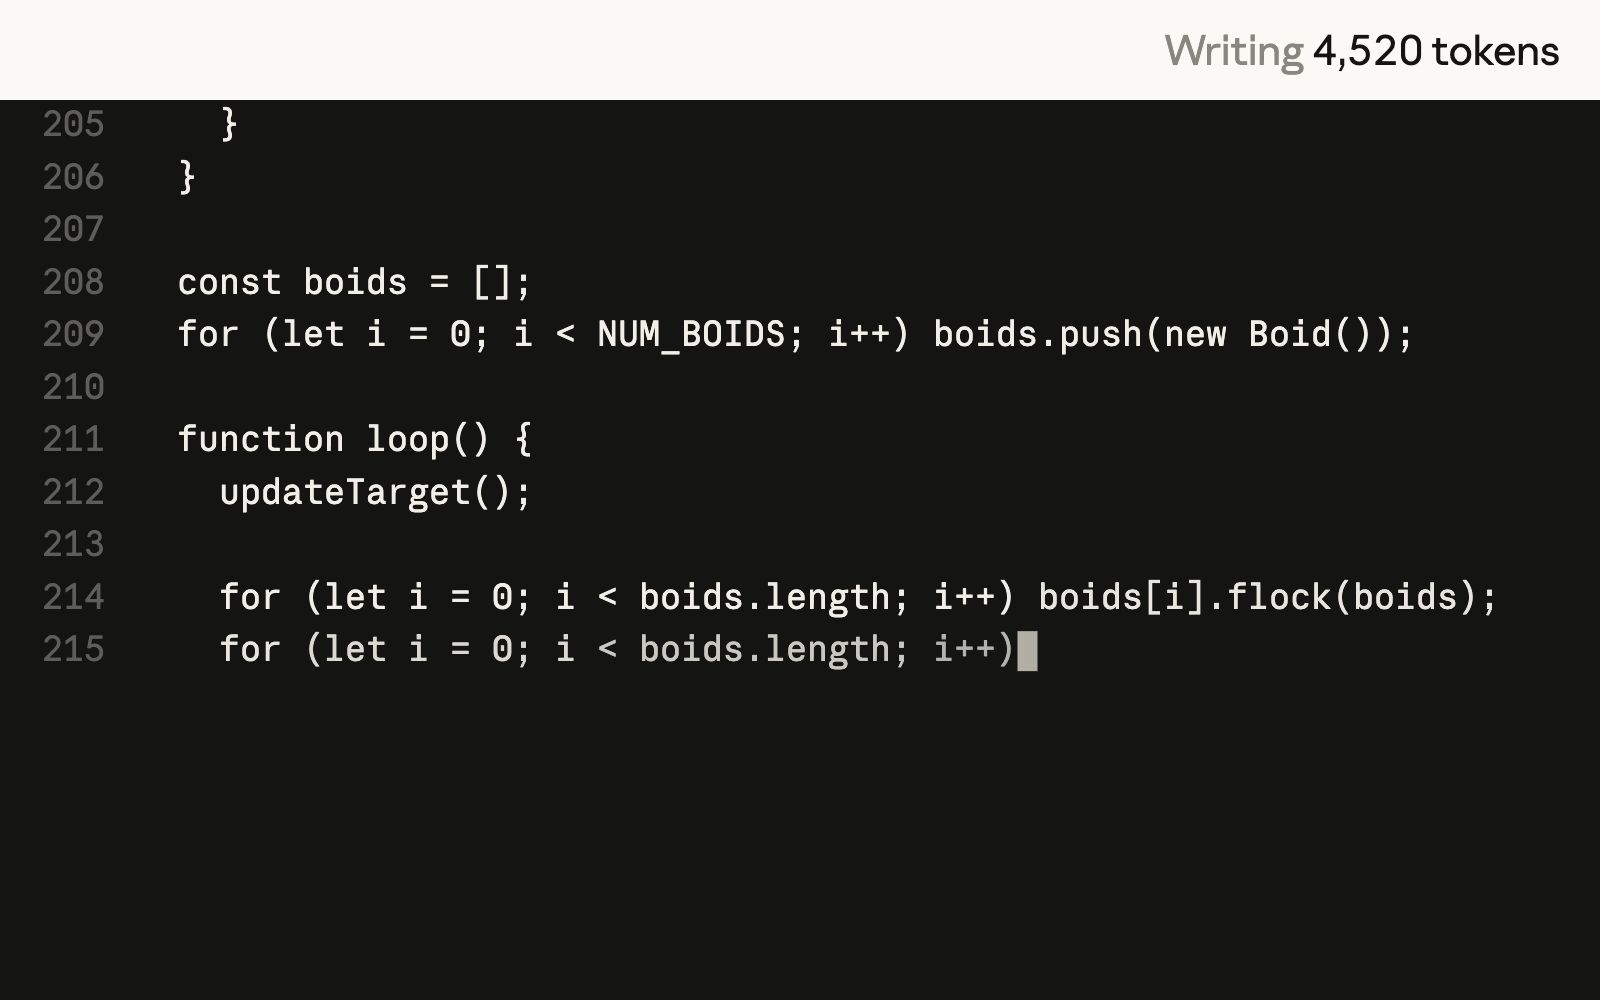
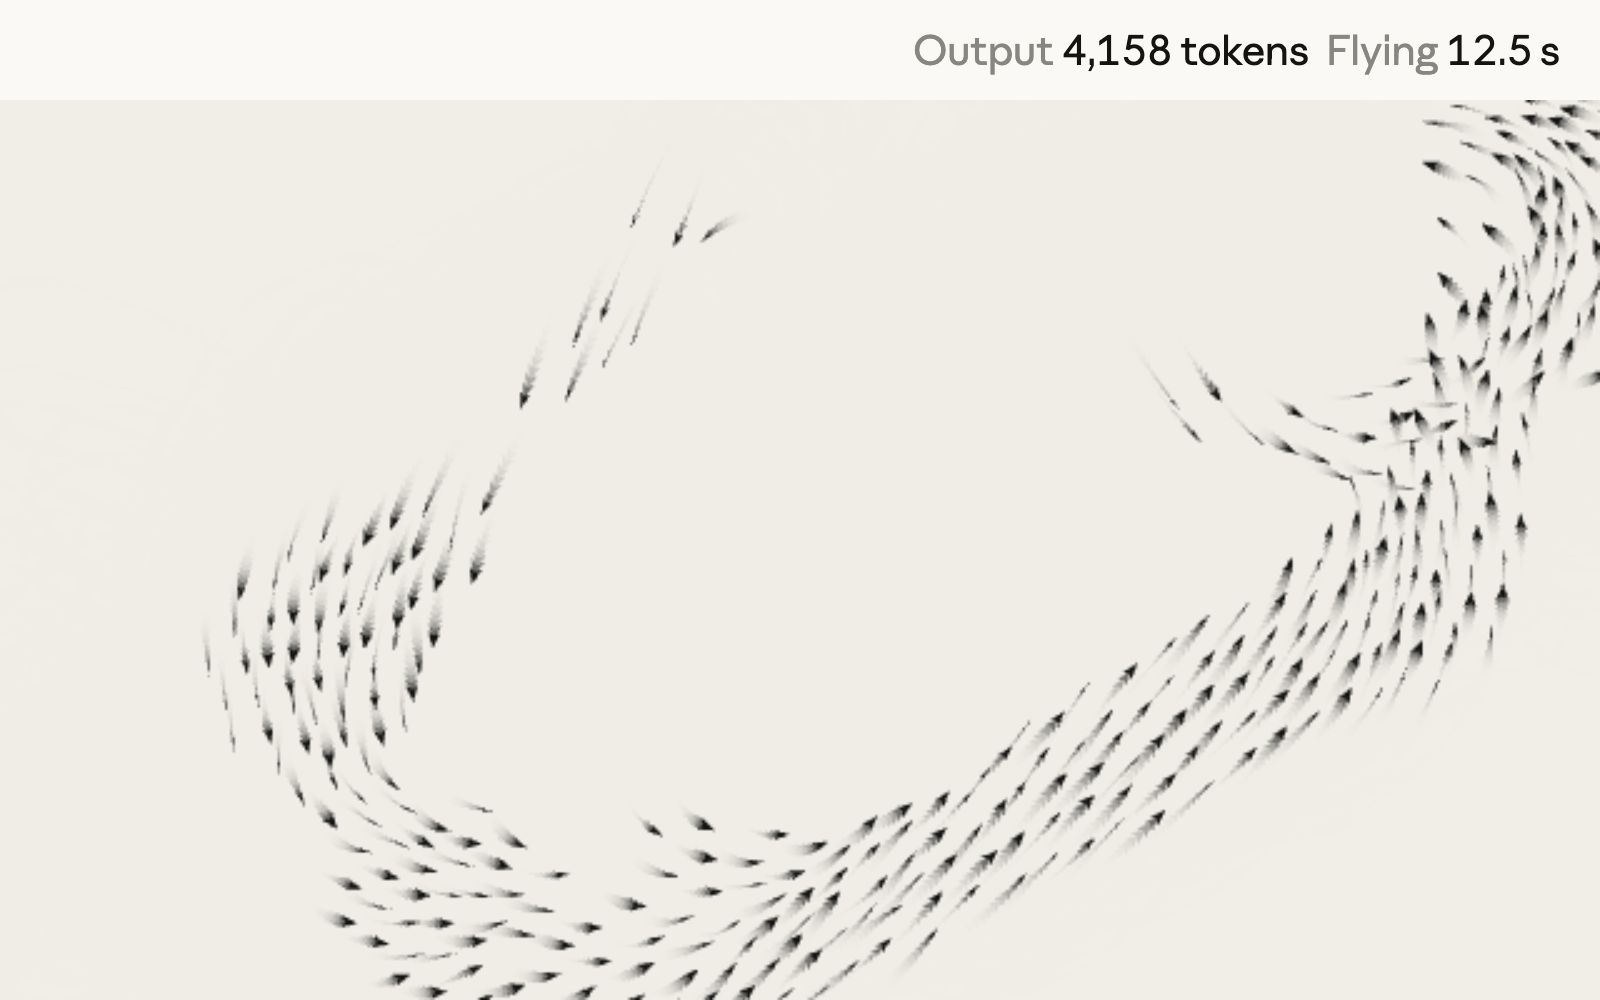
Effort 可以在成本、速度和品質之間取捨。Claude Code 和 Claude App 預設 Medium,Claude Platform 預設 High。設定低,回得快、用的 token 少,適合例行工作;設定高,想得比較久,也會更仔細檢查自己的成果。
安全
對齊
Sonnet 5.5 沒有把能力推到新的前沿,所以評估集中在任何能力等級都會有的風險:違背使用者的利益、誤導使用者、配合高風險的濫用。
在約 1,850 個情境的自動行為稽核中,多數對齊、抗濫用、誠實指標都進步或持平。在新的「圍堵」測試裡,它很少試圖逃出沙盒,接近表現最好的 Opus 5.5,也是所有模型裡最不會去試探容器邊界的。整體來說 Opus 5.5 還是略好一點,但沒有發現 Sonnet 5.5 追求跟使用者意圖衝突的目標。
防護
- 資安:能力比 Sonnet 5 大幅提升,所以用跟 Opus 5.5 類似的防護。日常開發中找 bug、修 bug 可以照常做,高風險的資安任務會明確轉回 Sonnet 5。
- 生物:跟 Sonnet 5 一樣。多數研究、教育、臨床工作不受影響,但部分微生物學和病毒學請求可能被誤擋。
- 蒸餾:第一個帶有「防止推理被抽取」分類器的 Sonnet;也擴大 preserved thinking,Claude 的思考內容會綁在建立它的帳號上。大多數開發者不會感覺到差別,但在帳號之間搬對話(包括在 Claude Code 中途換帳號)會受影響。
開始使用
跟 Opus 5.5、Sonnet 5 一樣可以零資料保留。所有平台都能用,包括 AWS、Google Cloud、Microsoft Azure,模型 ID 是 claude-sonnet-5-5。原本關掉 thinking 跑 Sonnet 的人,換到 Sonnet 5.5 前要先改用新的 between_tools 設定(一樣不會在一開始就思考)。
詞彙對照
| 原文 | 意思 |
|---|---|
| effort | 投入程度:控制模型想多深、花多少 token,分 Low / Medium / High / Xhigh / Max |
| agentic coding | 讓 AI 自己規劃、執行多個步驟來完成程式任務 |
| tool call | 工具呼叫:模型去執行指令、讀檔、搜尋等動作 |
| cache read | 快取讀取:之前送過、內容沒變的部分,重讀時用便宜很多的價格計費 |
| subagent | 子代理:把一部分工作分給另一個模型處理 |
| fallback | 備援:偵測到高風險請求時,改由較保守的模型處理 |
| structured output | 結構化輸出:要求模型照固定格式(例如 JSON)回答 |
| preserved thinking | 保留思考:思考內容綁定帳號,防止被拿去訓練別的模型 |
| zero data retention | 零資料保留:請求處理完不留存資料 |